“自己跑出去”解决物理 AI?世界模型研究者 Sonia Joseph:这是个“好听的故事”
AI 正在加速代码研发,但这种加速能否跨越物理实验的时间与反馈约束,仍是递归自我改进叙事中待验证的一环。
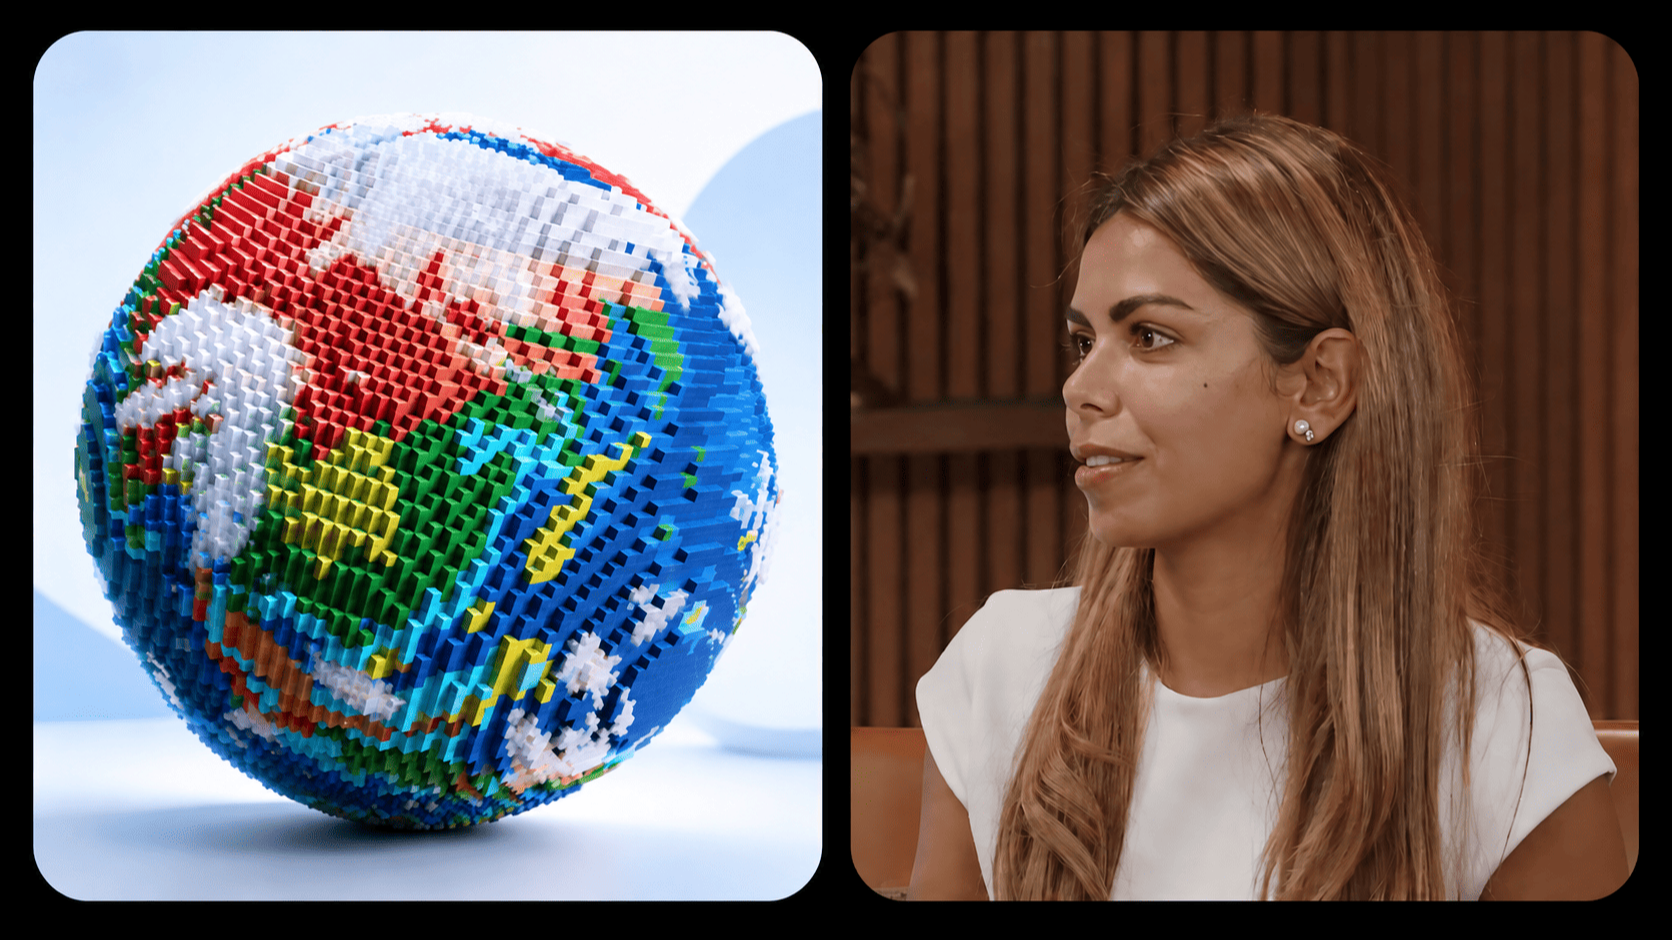
在 10 月 19 日上线的访谈中,世界模型研究者 Sonia Joseph 质疑:自改进的语言模型,能否顺势解决物理 AI?不一定[1]。
从研发加速到自主改进,还有多远
递归自我改进(RSI)的关键,在于系统能持续改进产生下一轮改进的方法。代码生成能力增强,是其中一项基础能力。
Anthropic 的内部统计显示,截至 2026 年 5 月,合并入库的代码中,超过八成由 Claude 编写;二季度,每位工程师日均合并的代码行数约为 2024 年的 8 倍。公司同时强调,完整的递归自我改进尚未实现,也并非必然[2]。
这组数据支持 AI 正在加速部分工程工作,但不能直接证明整体研发效率提高了 8 倍,更不能据此推出模型已能自主设计、训练下一代模型。代码执行之外,研究目标的选择和实验结果的判断仍是重要缺口[2]。
物理瓶颈,卡在反馈与验证
DeepMind 研究者在《From AGI to ASI》中提出“具身瓶颈”:AI 可以快速提出物理规律或生物机制的假设,但验证仍受现实实验的时间约束。报告将其列为潜在瓶颈,影响程度尚属开放问题[3]。
机器人领域也有更严格的证据门槛。10 月 13 日发布的《Who Improves the Robot?》提出 L0–L5 分级,最高一级要求独立验证的递归增益:在起点、经验和资源预算相当的条件下,更新后的改进程序,须比前一版带来更大的跨任务收益。作者梳理的文献中,尚无系统达到其定义下的物理 RSI[4]。
任务成功率提高,与“改进程序本身变得更有效”,需要分别验证。这也解释了为什么机器人自改进已有进展,物理 RSI 的证据仍有缺口。
AdaRSI 提供了怎样的进展
10 月 14 日发布的 AdaRSI 尝试把两条路径接起来:先改进工具和执行流程,再诊断持续失败的动作,只对必要的操作子步骤微调,使用系统自行采集的示范[5]。
以 GR00T N1.5 为执行器,在 RoboCasa365 的 16 个未见组合任务上,成功率从 4.6% 升至 13.8%;相比对每个操作子步骤都微调的方案,成功率略高,GPU 训练时间约为其 28%。全部 50 个任务的平均成功率则从 42.4% 升至 48.8%[5]。
这项进展的价值,是更准确地判断何时需要训练模型、何时只需调整调用方式。不过,单轮性能提升还不足以回答递归增益问题:随着改进程序连续更新,同样的经验和计算预算,能否持续换来更大的跨任务收益?
参考资料
[1] The Information. Are we building world models the wrong way?[EB/OL]. AI Deep Dive, (2026-10-19)[2026-10-20].
[2] FAVARO M, CLARK J. When AI builds itself[EB/OL]. The Anthropic Institute, (2026-06-04)[2026-10-20].
[3] GENEWEIN T, FRANKLIN M, LERCHNER A, et al. From AGI to ASI[EB/OL]. (2026-06-10)[2026-10-20]. arXiv:2606.12683.
[4] ZHOU H, YANG F, CHEN Z, et al. Who improves the robot? Toward physical recursive self-improvement[EB/OL]. (2026-10-13)[2026-10-20]. arXiv:2610.18842.
[5] WANG P, CHANG Y, MA Z, et al. AdaRSI: On-demand recursive self-improvement for embodied agents[EB/OL]. (2026-10-14)[2026-10-20]. arXiv:2610.20474.
杨发泽
Fizz Yang关注:计算机/电子/新消费
邮箱:faze.yang@infocase.world
最新发布
纯汽油车份额跌破全球新车一半,马斯克称未来几乎都是电动车
2026年上半年,纯汽油车约占全球新车销量的49%。混动和纯电同时分走市场,电动化扩张并不意味着发动机同步退出。
 新闻
 新闻
广发基金接入豆包,基金规则和投研观点开始变成对话服务
广发基金接入豆包工作,上线连接器及三项知识服务技能。合作将机构内容带入AI对话入口,但不意味着自动交易、收益保证或替代投资者判断。
 新闻
木头姐转发AI测算:同样一度能量,“产出”接近人类10倍?
木头姐转发的ARK研究,以工资口径估算单位直接能耗对应的劳动价值,AI一栏接近人类脑力劳动的10倍。原图揭示了增长潜力,也需要分清能耗口径、完整成本与真实收入。
 分析
 分析
 报告