英伟达把AI工厂装进集装箱,还给智能体加上“门禁”
英伟达在柏林GTC发布集装箱式AI工厂参考设计与智能体安全参考架构,将部署速度、资源效率及权限控制纳入完整AI运行系统。
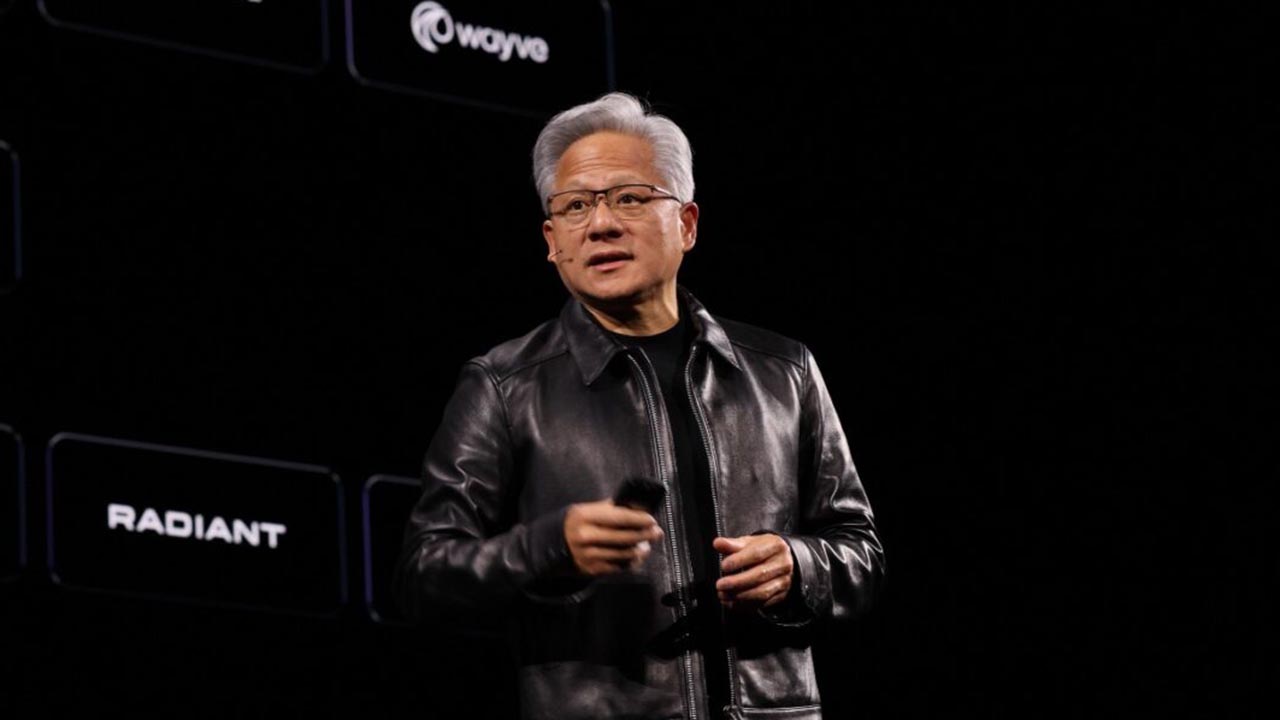
英伟达想把建设AI算力这件事,变得更像订购一套工厂设备:服务器、网络、机柜供电与液冷先在制造厂装好、测好,再一起运到客户现场。
10月21日,在柏林举行的英伟达技术大会(GTC)主题演讲上,黄仁勋介绍了集装箱式AI工厂参考设计DSX POD。公司称,在现场配套设施就绪的前提下,这种方案可将部署时间从约六个月缩短至最快14天,合作伙伴计划于2027年初开始向全球交付。
同一天,英伟达还发布用于约束权限、监控行为的企业智能体安全参考架构OpenShell,并扩充企业知识工具、本地AI电脑和机器人开发平台。智能体指能够分步骤执行任务、调用软件工具的AI系统;随着它们从回答问题走向操作文件和业务系统,算力之外,权限、安全和企业数据也成为基础设施的一部分。
这场演讲勾勒出的变化很清楚:英伟达正把产品边界从芯片与服务器,进一步延伸到AI工厂如何交付、智能体如何运行,以及企业怎样控制它们。
“14天部署”,省下的是哪一段时间?
DSX POD的核心做法,是把原本留在数据中心现场的部分集成工作,前移到制造工厂。
按照英伟达公告,合作伙伴会在运输前完成机柜间布线、供电连接、液冷管路和功能验证,将基于新一代鲁宾计算平台(Vera Rubin)的系统装进模块化集装箱。到达客户现场后,再连接已经准备好的电力、冷却、网络等设施。
因此,14天描述的是具备条件后的现场部署环节。土地、审批、电网接入和外围设施建设,不会因为设备装进集装箱就自动消失。相关AI工厂目前也仍处于计划交付阶段。
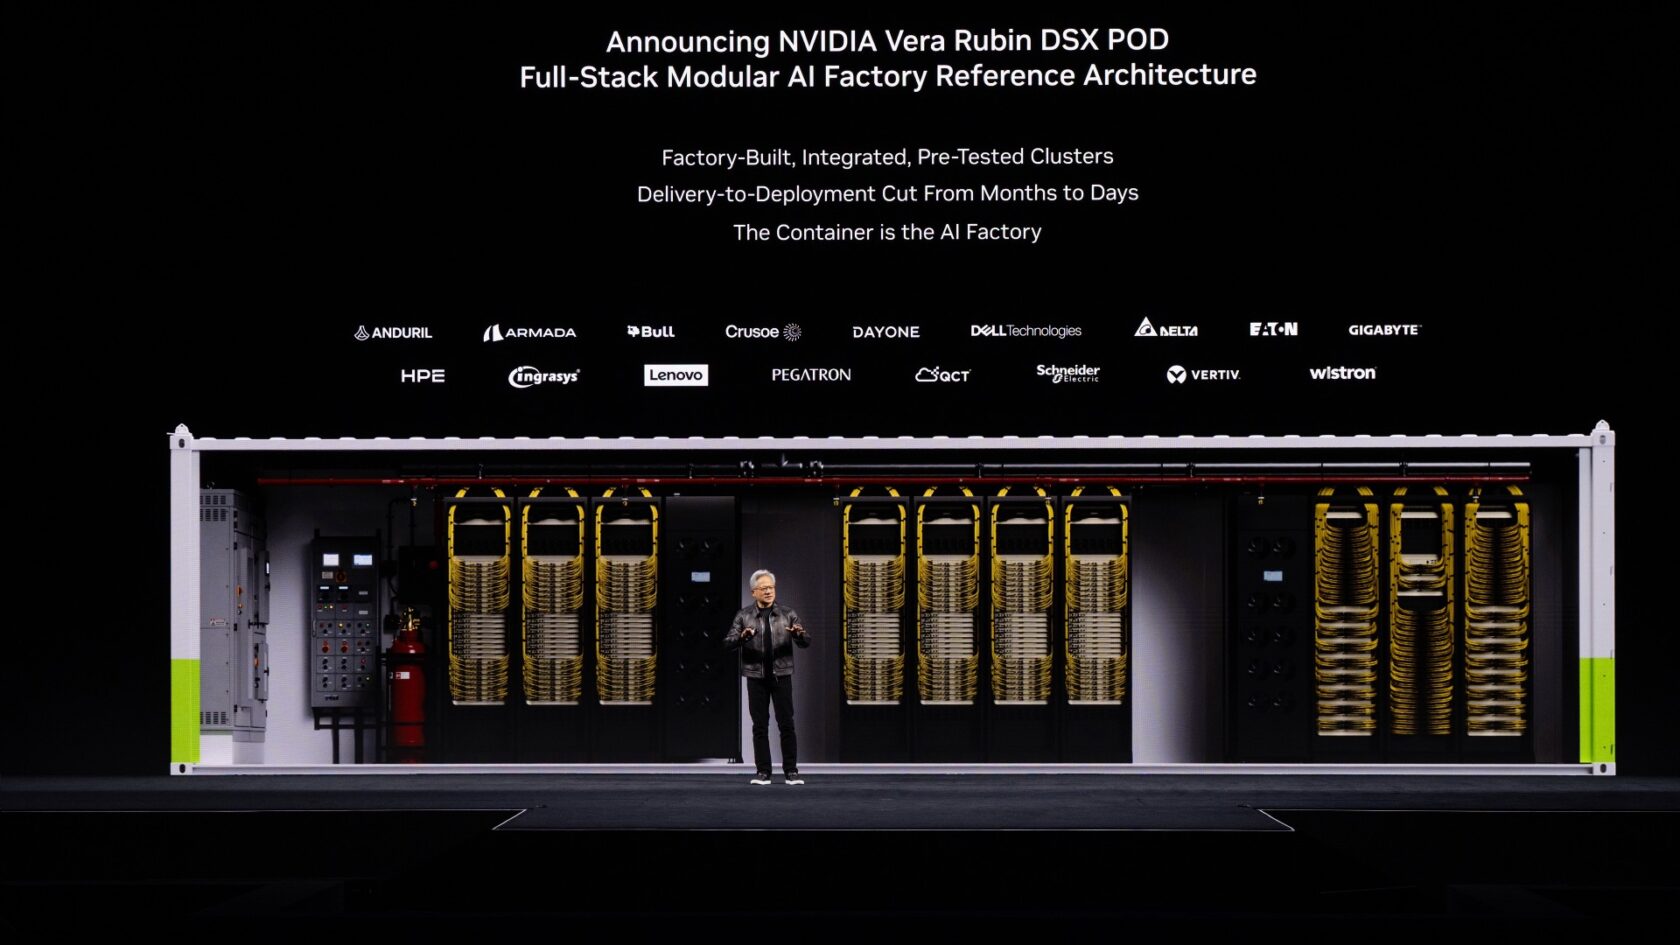
黄仁勋介绍DSX POD,身后为模块化AI工厂方案展示画面。来源:英伟达官方。
对运营商而言,缩短安装和调试时间,意味着昂贵设备有机会更早投入使用。能否进一步变成收入和回报,还取决于客户需求、设备利用率、电力成本及服务价格。
这也是成套交付值得关注的地方:它试图减少不同供应商的设备在现场逐项拼接、反复调试的时间,让扩容更接近可重复的工业生产流程。
AI工厂的另一张账单:电和水
更快装好设备,并不能解决全部资源约束。英伟达同时更新DSX AI工厂平台,将计算、网络、存储、供电和冷却作为一个系统协同设计。
在冷却方面,公司提出闭环液冷配合室外干式冷却器的方案:冷却液带走设备热量,再通过类似大型散热器的装置向空气排热,减少传统冷却塔蒸发水带来的持续补水需求。
英伟达称,相应设计可将设施冷却用水降至接近零。这里针对的是冷却用水,不意味着整座数据中心完全不需要水;当地气候也会影响最热时段是否需要额外机械制冷。
在用电方面,英伟达称,动态功率分配软件可以在相同AI输出下,最高减少30%的电力需求。另一套工具则尝试让部分计算任务的用电随电网状况、能源价格等条件调整。
这些属于公司给出的能力与测试口径,具体收益仍需结合工作负载和设施条件验证。对电力受限的运营商来说,关键问题是:已有供电预算能支撑多少有效计算,以及哪些任务可以灵活安排运行时间。
智能体拿到“钥匙”,也需要一道门禁
企业让智能体处理订单、运行代码或调用内部软件时,必须同时回答另一个问题:它究竟能碰哪些文件、访问哪些网络、执行哪些操作?
英伟达本次推出的OpenShell参考架构,建立在此前已有的OpenShell安全运行软件之上,进一步把模型计算、任务执行和安全控制组织成一套系统。公司表示,该参考架构现已提供。
其中,鲁宾平台负责模型运行,中央处理器承担任务编排和工具使用,独立的专用处理器及安全软件负责持续监控和策略执行。可以把它理解为:AI获得干活所需的工具,但访问范围由独立的控制层约束,越界行为需要被识别和阻止。
这套设计试图把安全控制放到实际运行环节,而不只依赖给模型写一句“不要越权”。它也不意味着智能体从此绝对安全;权限如何配置、工具如何接入、异常发生时怎样处置,仍是企业部署的一部分。
企业知识同样被纳入系统。按照英伟达介绍,新发布的智能体知识基础组件,帮助AI检索文档、理解数据库中的业务关系,并使用表格等结构化数据进行预测。例如,把客户、产品和订单之间的关联交给智能体理解,而不仅是让它搜索几份文件。
从这些发布可以看出,英伟达希望把“知道公司里的事”和“被允许做公司里的事”连接起来。前者决定智能体是否有用,后者决定企业能否放心扩大使用范围。
云端、桌面和机器人,按不同时间推进
新的计算平台也在向云服务延伸。谷歌云与英伟达宣布,基于鲁宾平台的A5X云端计算服务计划于下个月普遍开放,并扩大面向欧洲、中东和非洲地区的数据驻留与本地服务支持。两家公司公告中的时间安排表明,这仍是即将到来的普遍可用阶段。
在更贴近个人和开发团队的本地AI产品中,桌面开发设备DGX Spark的64GB版计划10月23日开始由合作伙伴推出;面向Windows的DGX Station工作站预计12月上市。黄仁勋在台上展示的RTX Spark笔记本,则已于此前一周发布。
这些产品覆盖不同使用环境:个人电脑上的智能体、小团队共享的本地模型服务,以及企业工程与仿真工作。把部分模型和工具留在本地,有助于缩短反馈链路、加强数据控制,但能运行多大的模型、支持多少并发任务,仍受内存、计算资源和软件适配限制。
机器人开发平台也获得更新。英伟达公布的进展包括新的机器人运行框架、学习工具,以及由合作伙伴打造、计划2027年初推出的人形机器人参考平台。这里的参考平台,是供研究者训练和验证能力的起点,距离大规模、可靠地进入真实工作环境,还需要更多验证。
英伟达在扩大一笔什么样的生意?
把这些公告放在一起,英伟达正在扩大自己参与AI部署的范围:从计算芯片、服务器与网络,到机房交付、功率调度,再到智能体的知识、工具和安全边界。
在这样的工作流程里,瓶颈会移动:模型生成答案快了,数据库查询、代码执行和外部工具响应,仍可能拖慢整项任务。从这套分工看,英伟达希望优化的单位,已经从一次模型回答扩大到一项完整工作。
统一设计有机会减少企业自己拼接系统的负担,也意味着客户需要更认真地评估整套方案的成本、兼容性和迁移能力。单项性能更强,未必自动等于整个业务流程更便宜、更稳定。
接下来,检验这轮发布的标准会很具体:集装箱式AI工厂能否按期交付、在真实现场缩短投产时间;同样的电力预算能否持续产出更多有效工作;智能体接入企业系统后,能否在权限明确、行为可追踪、异常可处置的条件下完成任务。
黄仁勋在柏林展示的,正是英伟达对这几道问题的一整套答案。答案能兑现多少,需要在发布会之后的建设、交付和日常运行中检验。
参考资料
[1] NVIDIA. NVIDIA Introduces DSX POD AI Factories to Accelerate Europe’s Infrastructure Deployment[EB/OL]. 2026-10-21.
[2] Brian Caulfield. GTC Berlin 2026: Live Updates From NVIDIA CEO Jensen Huang’s Keynote[EB/OL]. NVIDIA Blog, 2026-10-21.
[3] NVIDIA. European Ecosystem Builds World’s Most Efficient AI Factories With NVIDIA DSX[EB/OL]. 2026-10-21.
[4] NVIDIA. NVIDIA Launches OpenShell Reference Architecture for Safe AI Agents[EB/OL]. 2026-10-21.
[5] Erik Pounds. NVIDIA Agent Toolkit Expands, Grounding Enterprise Agents in Company Data[EB/OL]. NVIDIA Blog, 2026-10-21.
[6] Mark Lohmeyer, Ankur Mehrotra. Google Cloud and NVIDIA expand co-engineering collaboration to scale infrastructure for the agentic era[EB/OL]. Google Cloud Blog, 2026-10-21.
[7] Gerardo Delgado. Bringing the Spark to Europe: Local Intelligence Powers Next Wave of Agents[EB/OL]. NVIDIA Blog, 2026-10-21.
[8] NVIDIA. NVIDIA Advances Isaac Platform for General-Purpose Robotics With New Reference Humanoid, Frameworks, Simulation Pipelines and Data[EB/OL]. 2026-10-21.

智讯智库编辑部
关注:科技、财经、国际视野
邮箱:contact@infocase.world
最新发布
英伟达把AI工厂装进集装箱,还给智能体加上“门禁”
英伟达在柏林GTC发布集装箱式AI工厂参考设计与智能体安全参考架构,将部署速度、资源效率及权限控制纳入完整AI运行系统。
 新闻
宁德时代H股收跌11.41%,摩根大通降级:电池需求在涨,利润却面临重分配
宁德时代H股10月21日收报364.80港元、跌11.41%。摩根大通下调H股评级,担忧电动车产业链利润重分配,但保留A股增持判断。
 新闻
买块手表,还得和同学同品牌?小天才陷“封闭社交”争议
小天才儿童手表社交功能互通引发讨论。媒体采访到的客服及门店说法显示,跨品牌电话联系与微聊、好友圈、视频服务需要分别理解。
 新闻
木头姐转发AI测算:同样一度能量,“产出”接近人类10倍?
木头姐转发的ARK研究,以工资口径估算单位直接能耗对应的劳动价值,AI一栏接近人类脑力劳动的10倍。原图揭示了增长潜力,也需要分清能耗口径、完整成本与真实收入。
 分析
 分析
 报告