AI世界开始和你对话:谷歌发布Genie 4世界模型
Genie 4把实时场景修改、声音和角色对话结合起来,正向受信任测试者开放。创作预演与可靠的现实模拟,对它提出了不同要求。
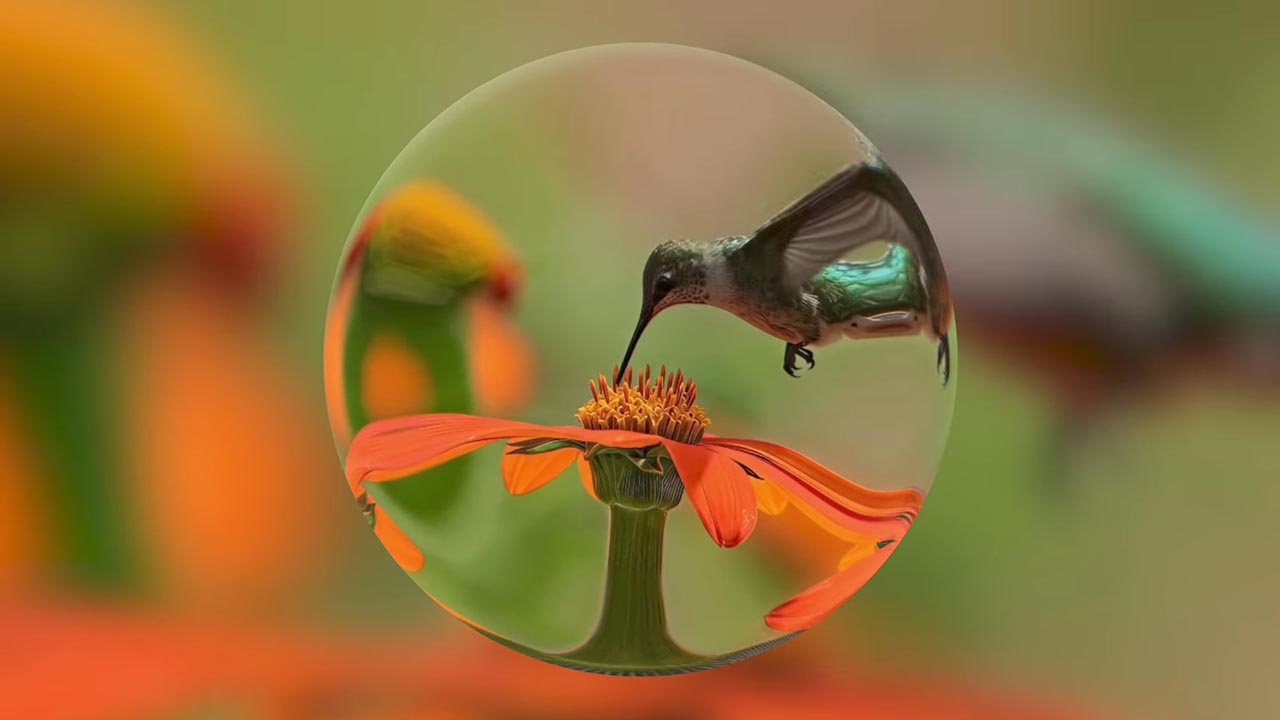
让一个AI生成的世界突然下雨,再走近里面的人,听他开口说话——谷歌正在把这类操作,放进同一个实时生成系统里。
10月27日,谷歌旗下人工智能研究机构DeepMind发布世界模型Genie 4。按照官方介绍,它能一边生成场景,一边响应键盘操作和文字指令,并同步生成环境声、音乐和角色对话。目前开放的是面向受信任测试者的研究预览,更广泛的用户与开发者访问仍待推出。[1]
所谓世界模型,可以理解为一个持续预测“接下来会发生什么”的系统。用户向左转,画面随之改变;用户要求变天,环境继续在新的条件下演变。它要维持的,是一段可以被不断干预的体验。
声音和对话,让生成场景多了一层互动
谷歌此次强调的变化之一,是原生声音生成:环境中的声响与画面同步生成,角色也可以根据输入或场景变化进行对话。相比只看一段生成视频,这意味着用户有机会通过行动和交谈,影响接下来发生的事。[1]
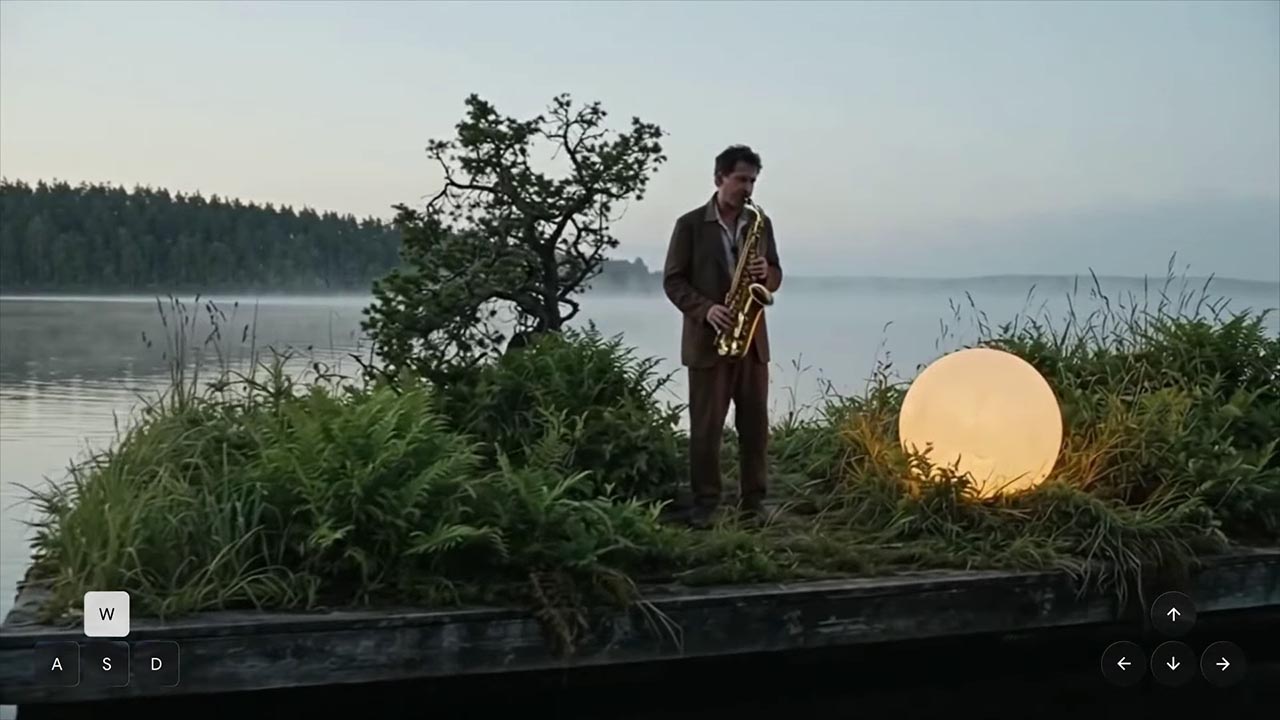
谷歌官方Genie 4模型生成演示画面,非实拍,也非本刊独立实测。
这会改变创作者试验一个点子的方式。导演可以先探索镜头与气氛,游戏团队可以先体验场景与互动,再决定哪些内容值得进入正式制作。对这些工作而言,能及时修改、低成本试错,可能比一次生成一段漂亮成片更有用。
谷歌还尝试把场景生成与另一类AI的观察、规划能力结合:由后者拆分任务、查看进展,再引导生成系统继续推进。这样的分工,体现了世界模型的一条发展路线——让视觉表现与任务逻辑协同工作。[1]
看起来像现实,还需要经得住连续操作
真正的考验,往往发生在演示继续之后:转身再回来,刚才的物体还在原处吗?连续修改几次,场景关系会不会混乱?一个看似合理的碰撞,能否在不同条件下保持同样的规律?
这些问题决定了世界模型能否走出短时展示。影视预演可以容忍部分细节漂移;若用来训练机器人或测试现实系统,错误的空间关系与物理反馈就可能传递错误经验。两类应用对可靠性的要求相差很大。
谷歌也承认,Genie 4在长时间运行、多次复杂修改之后,仍可能出现视觉细节和物体持续性漂移;复杂物理互动、声音准确性、文字可读性和空间精度也仍是研究问题。[1]
因此,这次发布值得关注的,是AI开始把“生成内容”和“响应行动”接到一起。至于它能否成为可信的模拟工具,还要看持续交互中的稳定性,以及正式开放后的外部检验。漂亮的一瞬间,距离可靠的一个世界,仍有一段路。
参考资料
[1] HADSELL R, RIVAS D, QI H. Genie 4: A new generation of world simulation[EB/OL]. (2026-10-27)[2026-10-28].

智讯智库编辑部
关注:科技、财经、国际视野
邮箱:contact@infocase.world
最新发布
3A大作场面实时生成!谷歌Genie 4展示惊人能力
谷歌正在将世界模型与Gemini的推理能力结合,让AI生成的虚拟世界拥有更复杂的行为和交互。随着交互和物理模拟能力不断提升,未来直接用世界模型生成一款完整的游戏,已经并非遥不可及。
 新闻
张一鸣6700亿元登顶胡润榜,AI创业者扎堆成为新面孔
胡润研究院10月27日发布百富榜,张一鸣以6700亿元估算财富位列第一,梁文锋、王兴兴等首次上榜。榜单以9月1日为财富截止日,反映股权估值,不能直接当作现金或企业利润。
 新闻
腾讯“绿泡泡”短剧月活达1.43亿,小程序成流量争夺新入口
据界面新闻援引QuestMobile数据,绿泡泡短剧小程序8月月活达1.43亿。10月首周周活较9月首周增长44.1%,这并非相邻周环比;用户和广告素材增长也不能直接等同收入与利润。
 新闻
Anthropic冲刺上市:六图看清115.6亿美元单季收入与隐忧
单季营业利润转正、净亏损却逾663亿美元。六图对照招股书,拆解收入、客户、算力成本和治理结构。
 分析
GPT-7或打穿具身智能问题,模型自研价值何在?
外部模型重塑具身产业格局,机器人企业亟需重组研发分工、重算全周期成本、重估自研回报。
 分析
 报告