同一台八卡服务器,AMD 如何让长文本 AI 请求跑得更顺?
AMD 测试显示,长上下文请求增多时,调整多卡分工和缓存格式,可以缓解模型服务的显存压力。
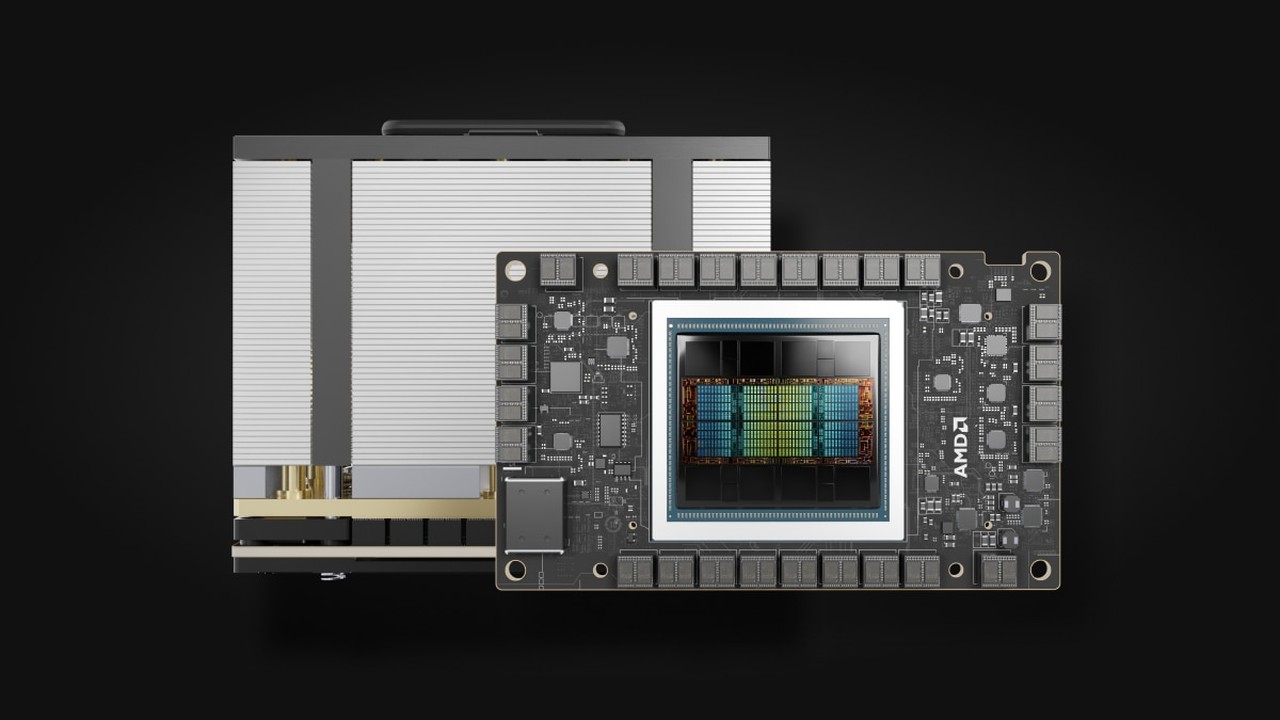
11月11日,AMD 发布一项部署测试:在一台搭载八颗 Instinct MI300X 加速器的服务器上运行 GLM-5.3-Flash,比较不同多卡分工方式在长上下文任务中的表现。[1]
AI 一次处理的材料越来越长,同时使用服务的人也可能越来越多;即使模型已经装进显存,服务器还要为每个请求保存处理中间信息。请求一多,显存就可能先被缓存占满。[1]
模型装得下,缓存也要有地方放
AMD 的八卡测试平台共有1536 GB 高带宽内存,GLM-5.3-Flash 的 FP8 模型权重约占306 GB。推理时,服务器还需要保存键值缓存(KV cache),避免模型反复计算已经处理过的内容。[1]
可以把缓存理解为每个请求的工作记录:材料越长、同时进行的请求越多,需要保留的记录也越多。当缓存空间用完,新请求就要排队,服务速度随之受影响。
AMD 比较了两种多卡配置:一种让八张卡共同处理任务,称为 TP8;另一种结合数据并行与专家并行,称为 DP8+EP8。两者使用同一台服务器,但将计算和请求分配给显卡的方式不同。[1]
单个请求快,多人同时用还要换种分工
在 AMD 的测试中,并发请求只有一个时,TP8 的输出吞吐量约为另一种配置的1.6倍。但当长请求数量增加,结果发生了变化。[1]
以每个请求输入9.6万、输出3.2万 token 的测试为例:并发数达到256时,TP8 的输出吞吐量约为每秒2317 token,DP8+EP8 约为每秒4719 token,后者约为前者的2.04倍。[1]
测试还比较了两种缓存精度。将缓存从 BF16 改为 FP8 后,在原有缓存仍有余量时,吞吐量变化不足2%;当 BF16 缓存装不下更多请求时,FP8 释放的空间开始带来收益。[1]AMD 已公布测试配置和复现方法,供开发者根据自己的模型与请求量调整部署。[1]
参考资料
[1] SAKHAMOORI P, DEOPUJARI M, TSENG J, et al. Parallelism for long-context serving: GLM-5.3-Flash on MI300X[EB/OL]. AMD ROCm Blogs, (2026-11-11)[2026-11-12].
杨发泽
Fizz Yang关注:计算机/电子/新消费
邮箱:faze.yang@infocase.world
最新发布
飞猪披露双11成绩:活动商品履约交易额增60%,交易用户增41%
界面新闻从飞猪获悉,双11活动商品履约交易额同比增60%、交易用户增41%。活动以提前购买、之后预约的套餐为主,具体履约统计口径尚未披露。
 新闻
赵丽颖AI肖像纠纷已开庭,红果运营方及其股东被诉
据澎湃新闻,赵丽颖与红果短剧运营方、其全资股东及一名自然人的肖像权纠纷已于11月10日开庭,尚未宣判。争议涉及被指未经许可使用AI合成人像等行为。
 新闻
彭博:字节拟在未来数周推出个人AI助手
彭博11月11日报道,字节跳动计划未来数周推出个人AI助手。财新此前披露,内部项目Spell于4月启动,由手机助手团队主导,计划与豆包产品结合。
 新闻
AI设计的基因开关,让小鼠脑细胞亮了起来
研究者把AI设计的基因调控序列带入了细胞和小鼠实验。这场分享揭示,生物AI接下来要比拼实验验证、数据质量和研究流程。
 分析
马斯克谈逾万亿美元芯片厂、机器人出租:62分钟访谈解读
从芯片制造、电力和数据中心,到机器人与星链,马斯克试图把AI需求接入同一套工业体系。巨额目标背后的成本、口径与执行条件同样值得拆解。
 分析
 报告