GPT-6.2 Astra操控双臂机器人,16项任务平均成功率升至41.2%
XDOF的真机测试显示,GPT-6.2 Astra的平均任务成功率为41.2%,比9月GPT-6 Astra的19.6%提高21.6个百分点。
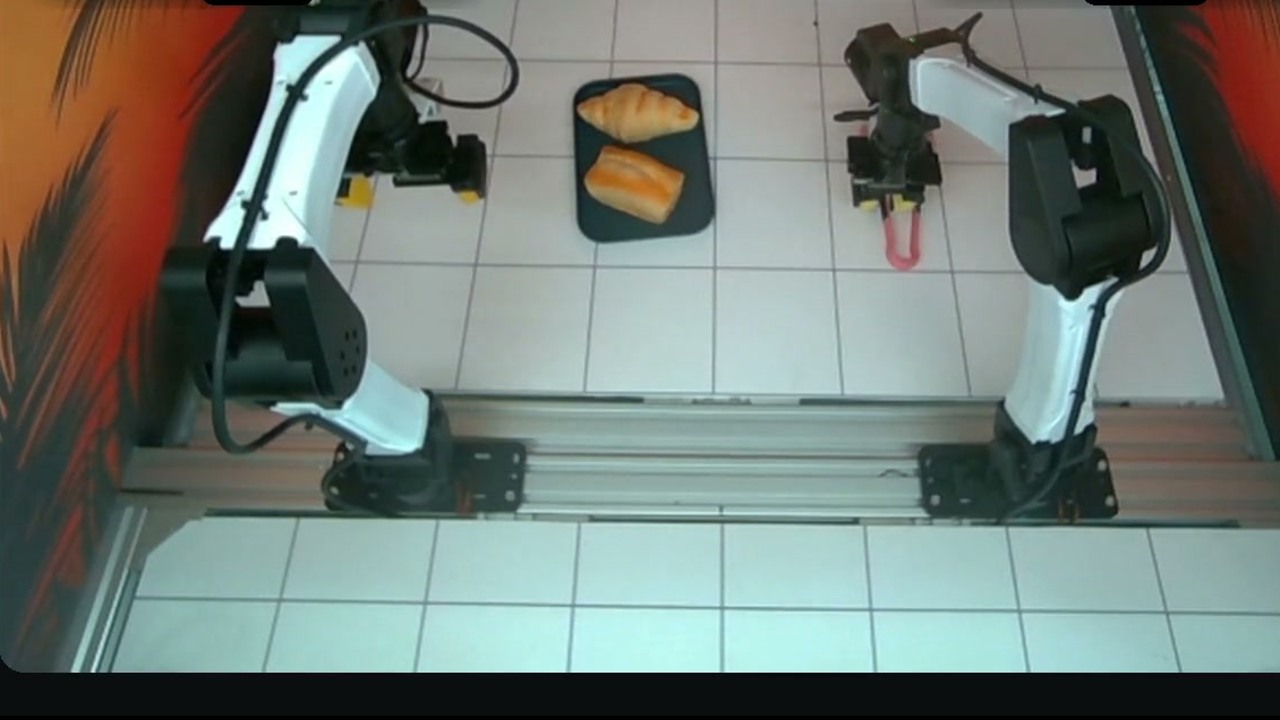
机器人评测机构XDOF公布一轮真机测试。在同一项名为Ember-0的基准上,OpenAI的GPT-6.2 Astra操控双臂机器人完成任务的平均成功率为41.2%。XDOF披露,9月初用GPT-6 Astra做同类测试时成绩为19.6%。两次分数相差21.6个百分点,新版的成功率约为旧版的2.1倍。[1][2]
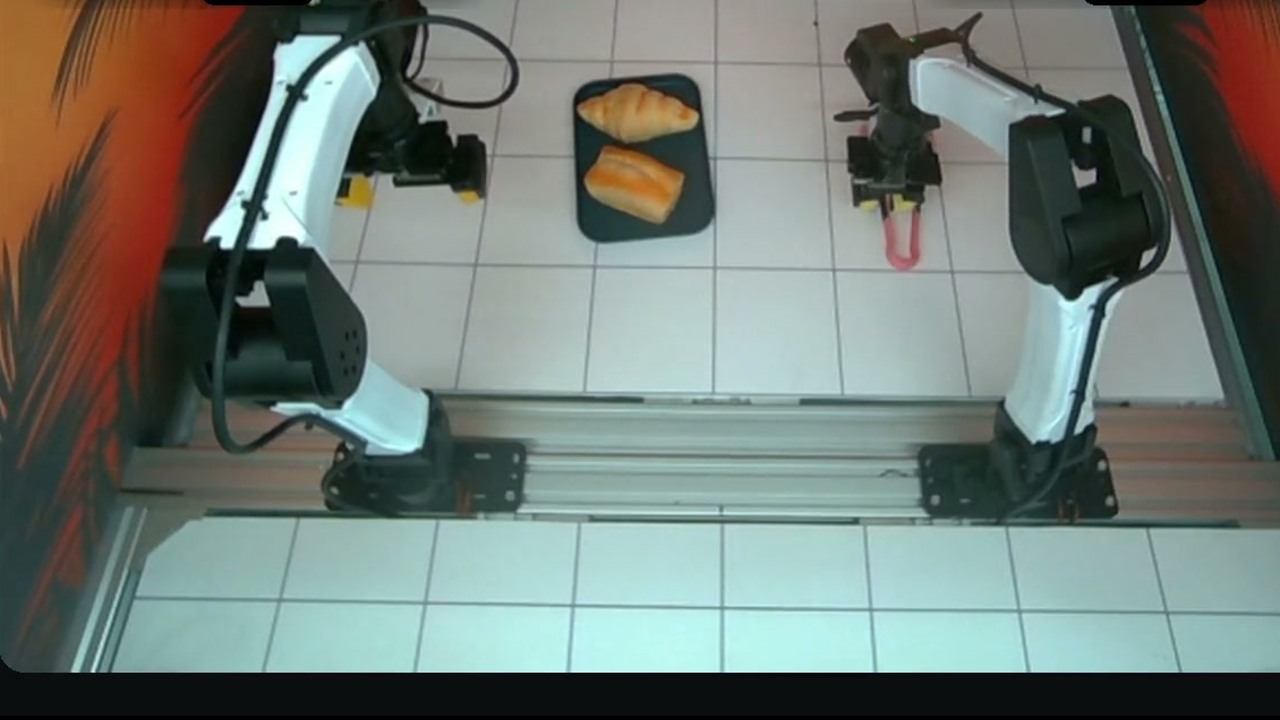
Ember-0有16项桌面操作题。它让两个机械臂打开一件折起来的T恤,从被遮挡的位置拿记号笔,或用夹子取物。每个任务按协议重复30次,再把16项各自的成功率等权平均。这样的设计可以减少某项特别容易的任务拉高总分,也让表现改进有一个固定的比较尺度。榜单注明,有效对比只纳入完成评分的试验,缺失结果不会当成零分。原始试验记录还可逐次查看,便于区分模型做错一步与整场试验无法评价。[2][3]
让模型看台面,再决定机械臂的动作
评测把模型接入现成的双臂工作站。多路摄像头提供台面画面,模型据此输出下一段动作,机器人执行后,模型再看新的画面继续处理。以夹面包为例,模型要识别夹子的受力端,机械臂得抓对位置,随后还要用合适力度夹住面包。只要其中一步偏了,后续就要重新看、重新抓。测试记录的不仅有任务最终成败,也有模型是否完成各个检查点、运行耗时和调用成本。[2][3]
XDOF在介绍早期基准时指出,模型有时会在任务实际完成之前就判断成功。折叠织物也是难点,机械臂抓到衣服边缘后,布料会不断变形,下一次落点需要随画面更新。对工厂和仓库来说,动作做成一次只是起点;机器人能否从失败中恢复、循环用时是否稳定,以及最终需要多少人工介入,才会影响部署效果。[3]
平均成功率提高21.6个百分点,仍低于一半
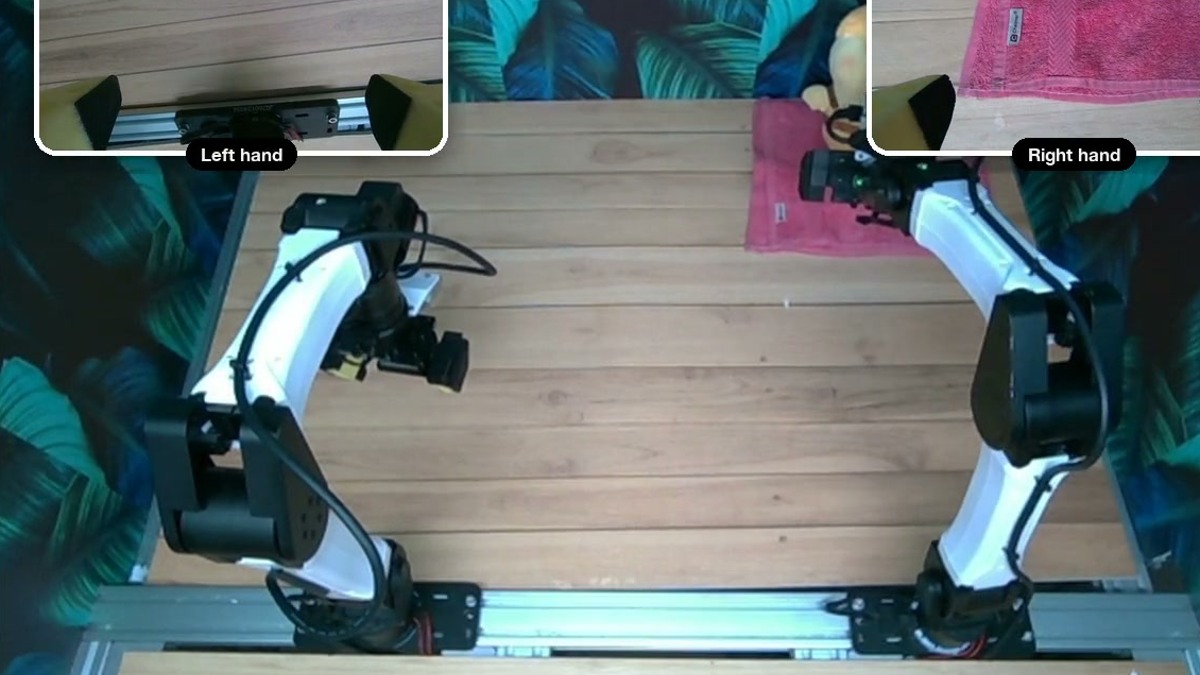
41.2%的成绩意味着在既定任务和评分中,成功的比例仍低于一半。测试由XDOF组织,场地、物体和机器臂配置比开放环境可控,能拿来比较同台模型的变化。把一批机械臂放到真实工位,操作环境、物体形态、节拍和安全要求都会变化。现在的总分也会把不同任务的难度和模型的解题成本压缩成一个数字。[2][3]
XDOF认为这项入门基准可能很快被更强的模型推近上限。接下来可以对照新版逐项录像,找出增长是来自更多任务终于做得出来,还是原先偶尔成功的动作变得稳定。两种改进都能拉高总分,企业采购时看的应用范围和人工接管成本却有所不同。[1][2]
参考资料
[1] XDOF,GPT-6.2 Astra在Ember-0的新版评测结果。
[2] XDOF,Ember-0公开榜单与评测口径。
[3] XDOF,Ember-0评测设计及早期真机操作记录。

智讯智库编辑部
关注:科技、财经、国际视野
邮箱:contact@infocase.world
最新发布
马斯克警告AI算力回款若晚几个月,行业或多垫数千亿美元
马斯克把资金压力指向算力设备从付款到稳定创收的时间差。甲骨文同期称,履行其与OpenAI合同所需资金已经落实。
 新闻
GPT-6.2 Astra操控双臂机器人,16项任务平均成功率升至41.2%
XDOF的真机测试显示,GPT-6.2 Astra的平均任务成功率为41.2%,比9月GPT-6 Astra的19.6%提高21.6个百分点。
 新闻
Lean与Mathlib确认黎曼猜想形式化证明通过验证
联合声明确认阿尔珀盖提交的经典黎曼猜想证明通过编译、目标命题比对和多个检查器核验。研究者披露证明过程得到Claude协助。
 新闻
 分析
SAP单季度收入创54年历史新高,ERP反被AI逆天改命?
AI在这些企业里发生了什么化学反应?这些巨头又是如何迎接AI时代、将AI融入业务的呢?
 分析
 报告