本地运行人工智能是浪费硬件?奥特曼把争论指向内存
以10月29日访谈为起点,拆解本地与云端计算的利用率、既有设备成本,以及隐私、离线和响应要求。5%仅为受访者举例。
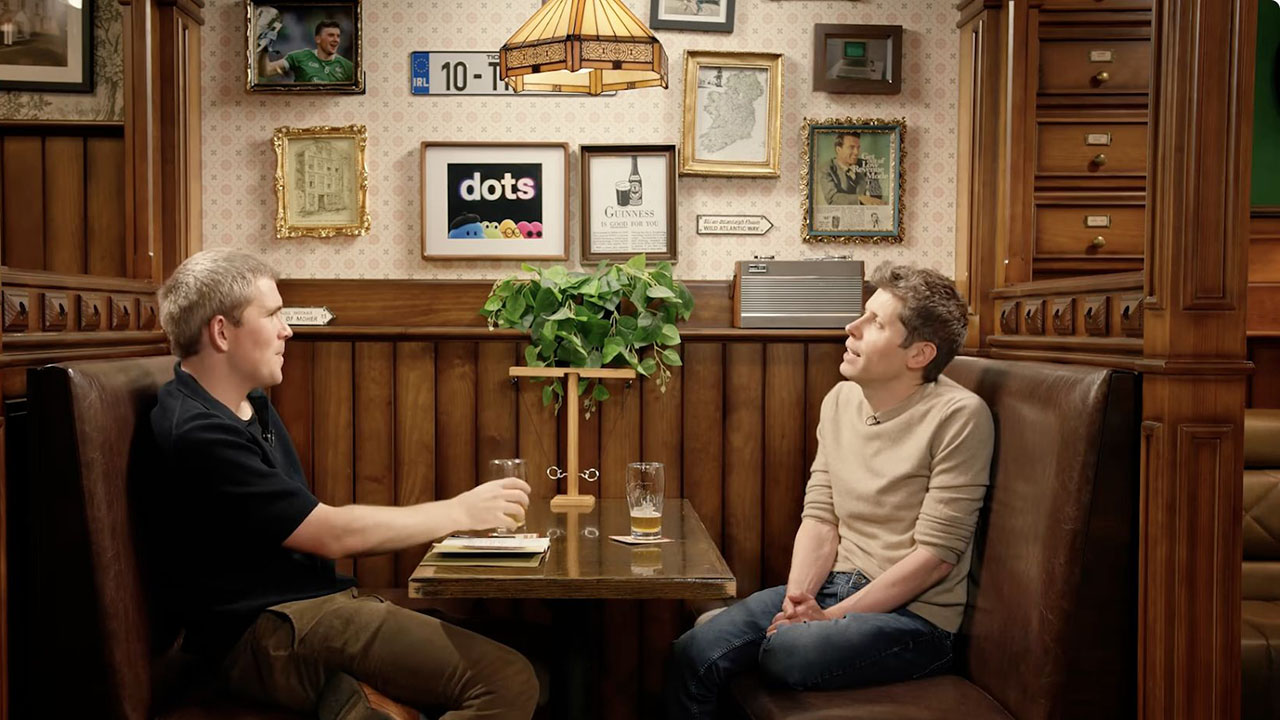
个人电脑已经能运行人工智能模型,为什么还要不断扩建数据中心?奥特曼给出的回答,落在一个很少出现在模型排行榜里的指标上:硬件到底有多忙。
在10月29日发布的《Cheeky Pint》访谈中,人工智能公司OpenAI首席执行官萨姆·奥特曼与主持人约翰·科里森讨论算力供应。他认为,在资源紧张的环境里,把稀缺内存分散到个人设备、却只在少量时间使用,从全球配置效率看可能很糟糕;集中在云端提高利用率,更有利于应对供应约束。
这是一项关于资源利用方式的判断。要评估它,需要同时看清他的前提,以及个人和企业用户还在意哪些成本。
开放模型,并不会让硬件需求消失
本地推理,指模型在用户自己的电脑或设备上运行并生成结果;云端推理,则由远端服务器完成计算,再把结果传回。
开放模型的代码或参数,可以降低获得模型和自主部署的门槛。但运行它,仍然需要处理器、内存和电力。模型能不能下载,与运行资源是否充足,是两个不同的问题。
奥特曼谈到的内存,是计算时暂时存放数据的硬件资源。他用“只使用约5%的时间”举例,强调个人设备可能存在大量闲置。不过,节目没有为这个比例给出调查样本或测量方法,不能把它当作所有个人电脑的实测平均利用率。
这段话出现之前,两人正在讨论存储厂商经历过的扩张与收缩,以及为什么高价格未必立即换来足够的新产能。它的背景是供应链约束,不能直接推广为每一种本地部署都不划算。
集中使用,怎样降低单次服务的成本?
一台设备需要先付出购置等固定成本。如果它能在同一段时间里为更多请求服务,每次有效计算所分摊的固定成本,就有机会下降。
云端可以汇集不同用户的需求:一个人的任务结束后,资源可以继续用于其他人的任务。这是提高利用率的一条路径,也是奥特曼这段判断中最清楚的经济逻辑。
但集中部署并不会自动消除闲置。用户可能在相近时段集中请求,服务需要保留余量,还要承担运维、网络和可靠性等成本。能否更便宜,最终取决于实际负载和完整成本。
对个人设备,也需要分清比较起点。一台已经购买、同时承担办公等任务的电脑,与为人工智能额外购置的一整套设备,不能简单放进同一张成本表。人工智能使用时长较低,也不能直接推导出整台电脑其余时间都在浪费。
用户购买的,还有离线、响应与控制权
利用率很重要,但它没有涵盖所有使用价值。
有些任务需要在断网时继续工作;有些交互希望减少网络等待;有些组织则对数据能否传出本地有严格限制。对这些场景,即使本地设备利用率不高,保留本地处理能力仍可能有价值。
本地运行可以减少向远端发送数据的需要,但它也不自动等于安全。应用权限、存储方式和设备保护仍然重要。云端同样需要评估数据处理与安全机制,不能只凭部署位置做结论。
因此,开放模型是否有价值,与把所有计算都搬回个人电脑是否高效,也需要分开判断。模型可获得、可调整、可自主部署,提供的是选择空间;资源利用率讨论的,则是具体方案的运行效率。
争论的关键,是比较条件是否一致
奥特曼既是这场讨论的参与者,也是云端人工智能服务公司的负责人。他的供应链视角有助于理解集中部署的优势,但不足以独自回答每一个用户的部署选择。
更有用的比较,需要先约定相同的结果质量和任务规模,再计算购置、维护、能源、网络与迁移成本,并加入隐私、离线和响应要求。
现实中的选择也可能是混合的:一部分任务留在本地,另一部分交给云端。是否值得如此划分,要由具体工作负载来回答。
这段访谈最值得留下的问题,是“同样一份硬件资源,如何产生更多有效工作”。把这个问题问清楚,比仅凭“本地”或“云端”两个标签判断优劣,更接近用户真正要支付的成本和获得的价值。
参考资料
[1] Cheeky Pint. Why Sam Altman is against a single superintelligence:访谈及完整文字稿[EB/OL]. 2026-10-29.
[2] Cheeky Pint. Sam Altman’s case for making compute cheap[EB/OL]. 2026-10-29.

智讯智库编辑部
关注:科技、财经、国际视野
邮箱:contact@infocase.world
最新发布
用意念点咖啡、给妻子打电话:Neuralink展示脑机接口的日常新场景
Neuralink公布五组言语脑机接口演示,涵盖自动识别说话意图、唤起人工智能助手、点单与电话通话。设备仍处研究阶段,视觉恢复及全身机器人控制属于不同的后续目标。
 新闻
SpaceX跌破135美元发行价,强劲财报也没挡住科技股抛售
SpaceX在10月30日下跌6.4%,报134.72美元,低于135美元发行价。其超级智能业务收入已占总营收一半以上,使市场对人工智能需求、投入及回报的判断更直接影响公司估值。
 新闻
59.9万元,奔驰AMG把六缸带回GLC:加速之外,还卖什么?
AMG GLC 53在中国上市,搭载3.0升直列六缸与48V轻混系统,官方指导价59.9万元。它把动力响应、声浪及底盘体验放在性能表达的核心。
 新闻
Anthropic冲刺上市:六图看清115.6亿美元单季收入与隐忧
单季营业利润转正、净亏损却逾663亿美元。六图对照招股书,拆解收入、客户、算力成本和治理结构。
 分析
GPT-7或打穿具身智能问题,模型自研价值何在?
外部模型重塑具身产业格局,机器人企业亟需重组研发分工、重算全周期成本、重估自研回报。
 分析
 报告