谷歌发布编程模型Gemini 4 Hydrogen,可与旗舰模型分工接力
谷歌发布面向日常编程和多步任务的新模型,可与旗舰模型在同一任务中分工接力。开发者迁移时,需要结合当前促销价格、思考用量与任务容量重新核算成本。
谷歌11月12日发布人工智能新模型Gemini 4 Hydrogen,面向日常编程,以及能调用工具、分多步完成工作的人工智能助手。谷歌同时推出模型协作功能,让更强的模型负责规划,再把写代码、跑测试等执行工作交给Hydrogen。[1]
这给使用人工智能开发软件的团队提供了一种更细的分工:同一个任务推进到不同阶段,可以交给不同模型继续处理。新模型也已进入谷歌的开发接口,提供有限额的免费试用和付费调用。[2]
在一个任务里交接工作
谷歌的编程工作台Antigravity同步推出名为Orchestrator的模型协作选项。根据官方示例,同系列旗舰模型Gemini 4 Carbon可以先检查项目依赖、厘清问题并制定计划;Hydrogen随后修改代码、更新软件包、运行测试。执行遇到阻碍时,任务可以交回旗舰模型检查现状、调整计划,再继续推进。[3]
这种交接围绕任务进展动态发生。开发团队也可以自行指定各模型承担的角色。[3]
对团队而言,这意味着模型选择可以落到具体工序上:难以判断的问题使用更多推理,频繁重复的修改与检查追求较短等待时间。节省多少费用,则要由每一步的用量、返工次数和实际完成率共同计算。
速度提升有公司测试支撑,价格需要单独算
谷歌把此前的Gemini 3.8 Flash列为主要升级对象。该公司公布,在默认较高思考档位下,Hydrogen完成测试任务的速度为旧模型的2.5倍;在考察模型操作命令行完成任务的Terminal-Bench 4.1测试中,得分从18.2%升至57%。这些数字来自谷歌发布材料,本次报道没有对模型进行独立实测。[1]
调用费用有明确的时间差。按谷歌开发接口标准付费档,Hydrogen每处理100万个输入计费单位收费1.50美元,每生成100万个输出计费单位收费7.50美元。计费单位token是模型拆分和处理文字等内容所用的小片段;输出费用包含模型在给出答案前的思考用量。[4]
旧模型目前仍有促销:到2026年12月31日,输入、输出单价分别为0.75美元和3.75美元,2027年1月1日起恢复至1.50美元和7.50美元。因此,按当前标准档、相同输入输出用量计算,Hydrogen费用是旧模型的两倍。企业比较迁移成本时,需要把处理速度与单次任务账单分别测量。[4]
长任务要留出输入和输出空间
模型卡显示,Hydrogen由旗舰模型适配而来,可接收文字、图片、音频和视频。它使用约100万个token的统一上下文窗口,也就是一次任务中可容纳的信息空间;输入材料、思考过程和输出结果共同占用这一空间。[5]
开发文档说明,单次同步响应的输出上限为65,536个token。长材料输入后,留给思考和生成结果的空间会减少,团队需要按整个任务安排容量。[2]
Hydrogen提供低、中、高、超高四档思考深度,默认使用高档;增加思考深度会带来更长等待和更多计费用量。[2]
谷歌称,新模型从11月12日起在开发、企业和消费产品中全球逐步推出;聊天应用的免费用户由系统根据问题自动选择是否使用Hydrogen。[1] 在编程工作台,Hydrogen面向付费专业版和旗舰版订阅者开放;具体模型协作组合按订阅档位开放。[3] 模型卡提醒,模型仍可能编造内容,偶尔也会响应变慢或超时;完整安全评估报告尚待发布。[5]
参考资料
[1] KAVUKCUOGLU K. Introducing Gemini 4 Hydrogen[EB/OL]. (2026-11-12)[2026-11-13].
[2] GOOGLE. What's new in Gemini 4 Hydrogen[EB/OL]. [2026-11-13].
[3] THE ANTIGRAVITY TEAM. Gemini 4 Hydrogen and Orchestrator[EB/OL]. (2026-11-12)[2026-11-13].
[4] GOOGLE. Gemini Developer API pricing[EB/OL]. [2026-11-13].
[5] GOOGLE DEEPMIND. Gemini 4 Hydrogen: Model Card[EB/OL]. (2026-11-12)[2026-11-13].

智讯智库编辑部
关注:科技、财经、国际视野
邮箱:contact@infocase.world
最新发布
三星 AI 眼镜开启预订,携手眼镜品牌进入消费市场
三星与谷歌合作开发的智能眼镜将于 12 月在美国和韩国上市,消费者可以在两家眼镜品牌的多款镜框中选择。
 新闻
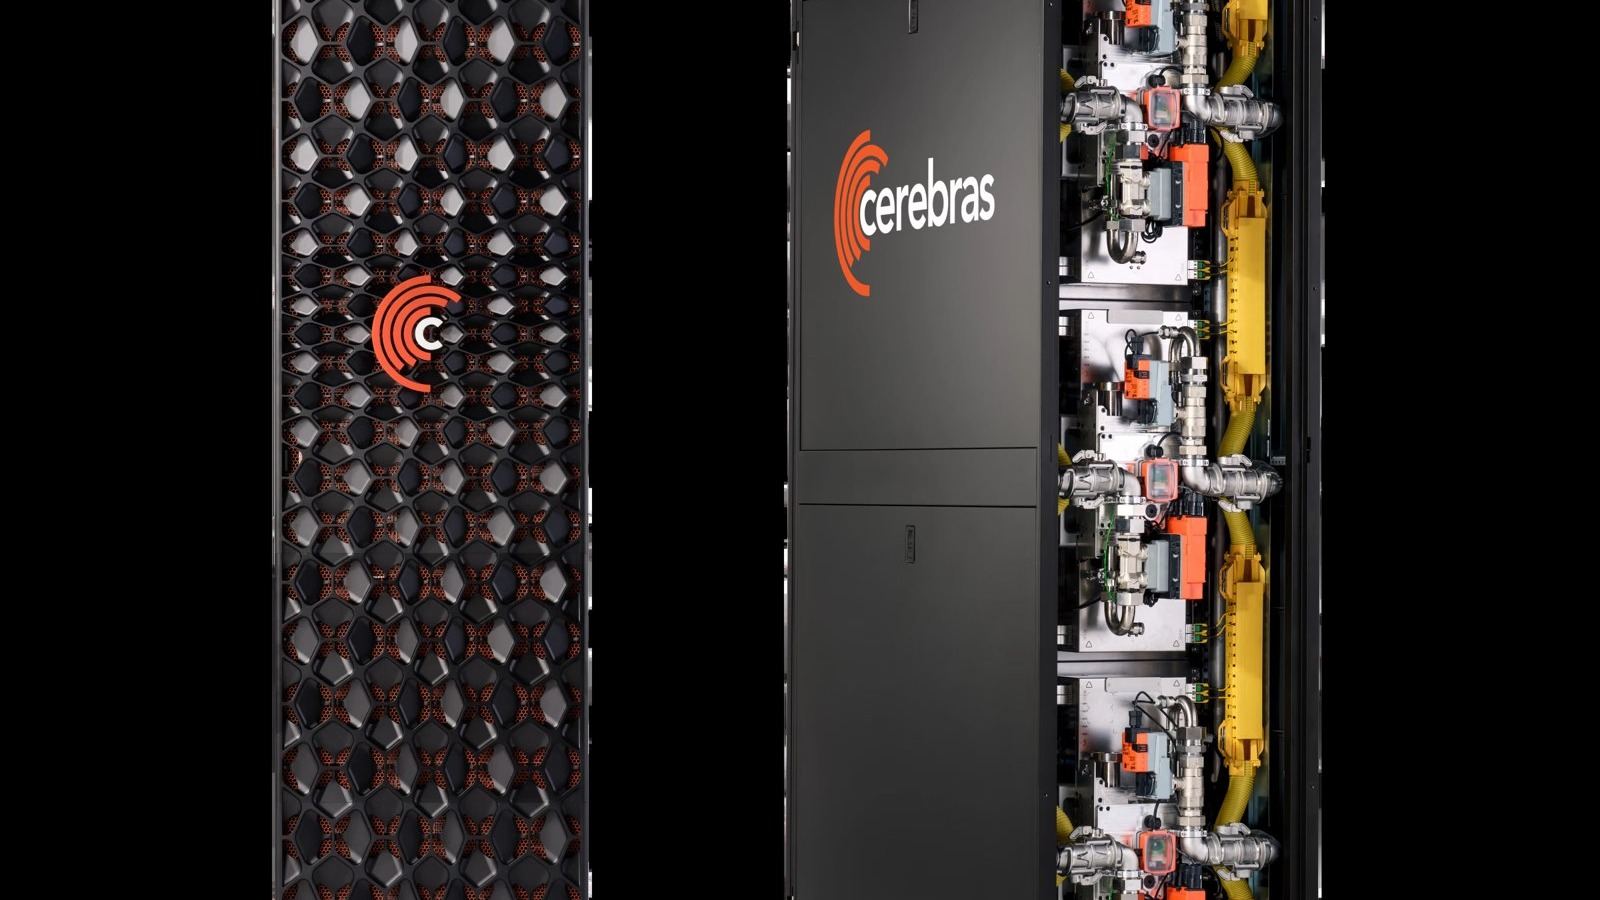
Cerebras 云业务收入增长近三倍,晶圆级芯片加速进入 AI 推理市场
Cerebras 三季度云及其他服务收入同比增长 265%,公司正通过自有云和合作伙伴扩大芯片的使用范围。
 新闻
SpaceX拟投逾740亿美元,在美国两州建设地面超算园区
SpaceX披露得州逾240亿美元、亚利桑那约500亿美元的超算园区规划。两地分别推进税惠与土地审批,亚利桑那规划用电需求从首期150万千瓦逐步扩展,供电服务协议尚未最终敲定。
 新闻
AI设计的基因开关,让小鼠脑细胞亮了起来
研究者把AI设计的基因调控序列带入了细胞和小鼠实验。这场分享揭示,生物AI接下来要比拼实验验证、数据质量和研究流程。
 分析
马斯克谈逾万亿美元芯片厂、机器人出租:62分钟访谈解读
从芯片制造、电力和数据中心,到机器人与星链,马斯克试图把AI需求接入同一套工业体系。巨额目标背后的成本、口径与执行条件同样值得拆解。
 分析
 报告