大客户自己造芯片,英伟达要亲自下场做最强模型吗?
Naval转发的判断把焦点放在英伟达的客户身上。谷歌和OpenAI自研芯片,英伟达也发布了自己的开放权重模型。
硅谷投资人、AngelList联合创始人Naval Ravikant在11月20日转引了一句对英伟达的判断。他认为英伟达得在前沿模型实验室掌握芯片设计之前,先具备开发一流模型的能力。原话出自X用户Mo 11月17日的一篇长帖。Mo把英伟达最大的竞争压力指向现有大客户。它们既购买GPU,又开始决定下一代算力应该用什么芯片。[1][2]
大客户造芯片,瞄准的是自己每天都在跑的任务
训练和运行模型需要反复搬运数据。芯片计算再快,内存送不过来或芯片之间交换太慢,任务仍会停下来等。自研芯片让实验室按自家任务搭配计算、内存和网络。尤其是调用量大、任务形态较稳定的推理服务,省下的电和每次响应的成本,会随着使用规模累积。
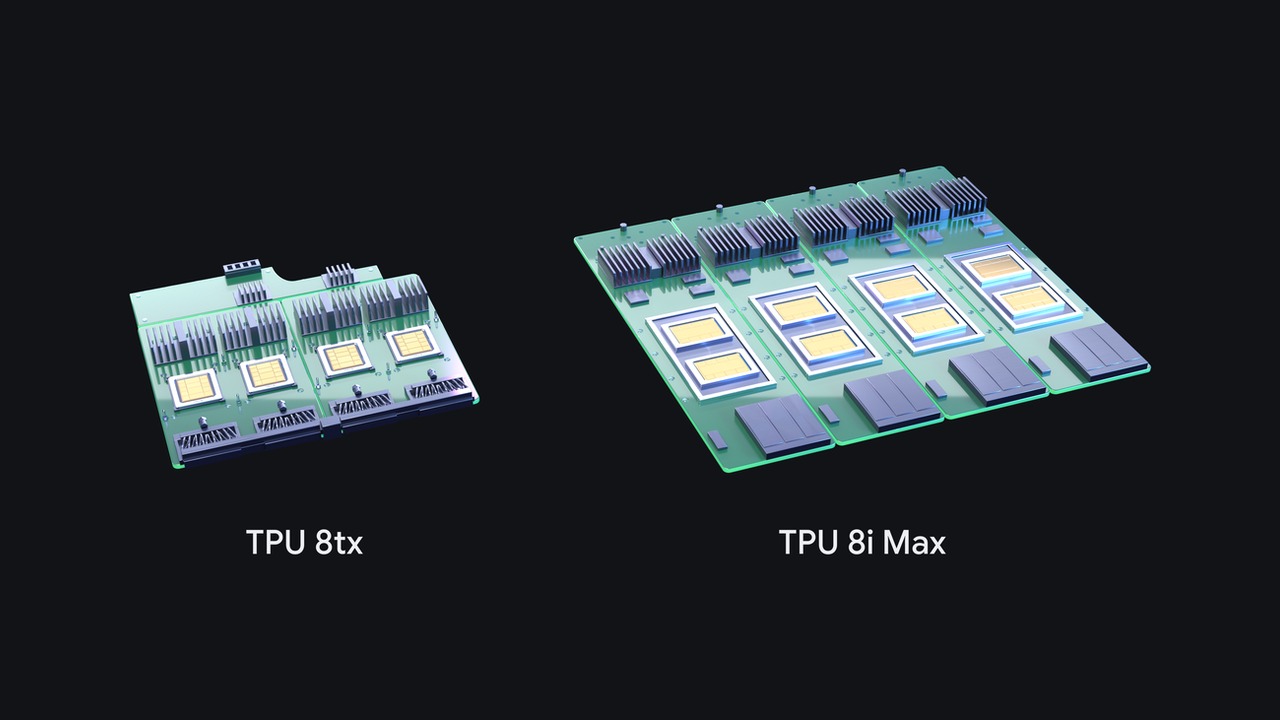
谷歌11月公布的第八代TPU已经按负载分工。TPU 8tx更偏重训练,8i Max面向推理。OpenAI与博通在2025年公布的合作,目标是部署10吉瓦的OpenAI设计加速器及相关网络系统。10吉瓦是部署计划。两家企业走到哪一步,要看芯片、机柜和电力何时准备好,以及客户工作负载能否稳定迁过去。[3][4]
自研芯片与买GPU可以长期并行。OpenAI在宣布博通合作前,也与英伟达签了部署英伟达系统的基础设施合作意向。大型实验室会把资源分到不同任务上。专用芯片可服务成熟、重复的工作负载,通用GPU则方便更换模型结构和软件工具。项目尚在早期时,团队通常更看重更换方向的速度。等调用量足够大,自研方案的固定投入才更容易摊薄。[5]
英伟达做开放模型,可以扩大硬件的用处
英伟达已经投入模型研发。今年3月,公司扩大Nemotron等开放权重模型阵容,覆盖编程助手、搜索和业务流程等任务,并把模型、训练工具和部署服务接到自家的硬件平台。[6] 对自行部署AI的客户,开放权重让他们能选择在哪里运行模型,以及如何把它接进现有系统。英伟达做这套产品,也能反过来验证新硬件运行实际模型的表现,给客户提供部署参照。
眼下的业务量为这场竞争提供了尺度。英伟达最新一季数据中心收入1076亿美元,同比增长110%,约占季度总收入的93%。[7] 客户自研是否蚕食这部分需求,要看多少新增任务被分给专用芯片,以及外部客户能否用合理的成本迁移过去。对英伟达而言,模型的价值最终也要在部署上体现。企业是否持续用它,能为分析GPU需求提供比单次模型排名更直接的线索。
参考资料
[1] Naval Ravikant,转引关于英伟达与前沿模型实验室的观点,2026年11月20日。
[2] Mo(@PersianMacroGuy),原始公开帖,2026年11月17日。
[3] Google,第八代TPU 8tx与8i Max公告,2026年11月9日。
[4] OpenAI与博通,自研加速器合作公告,2025年10月13日。
[5] OpenAI与英伟达,AI基础设施合作意向公告,2025年9月22日。
[6] 英伟达,扩大开放模型阵容公告,2026年3月16日。
[7] 英伟达,2027财年第三季度业绩,2026年11月17日。

智讯智库编辑部
关注:科技、财经、国际视野
邮箱:contact@infocase.world
最新发布
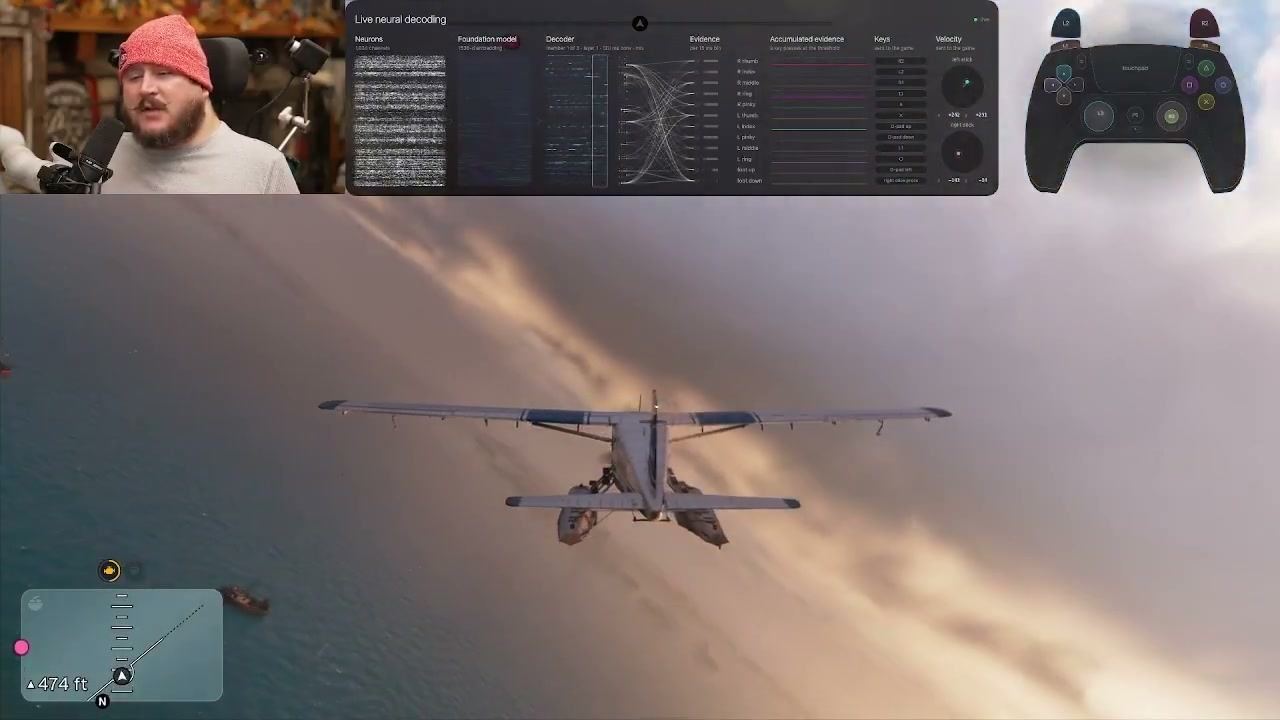
Neuralink公开GTA VI演示,植入者用脑机接口开船、开飞机
约2分钟官方视频展示了船只转向、水上飞机起飞和夜间驾车。参与者还讲解了怎样把手指、脚和手部的动作意图映射成游戏操作。
 新闻
大客户自己造芯片,英伟达要亲自下场做最强模型吗?
Naval转发的判断把焦点放在英伟达的客户身上。谷歌和OpenAI自研芯片,英伟达也发布了自己的开放权重模型。
 新闻
Anthropic七位创始人回顾创业,Claude靠编程打开市场
Anthropic发布约14分41秒的创始人访谈。创始人回顾了第一代Claude的局限、追赶同行的训练工作,以及Claude Code如何出现。
 新闻
 分析
SAP单季度收入创54年历史新高,ERP反被AI逆天改命?
AI在这些企业里发生了什么化学反应?这些巨头又是如何迎接AI时代、将AI融入业务的呢?
 分析
 报告